Transformer, Tokens und Wattstunden · 23. OKTOBER 2026
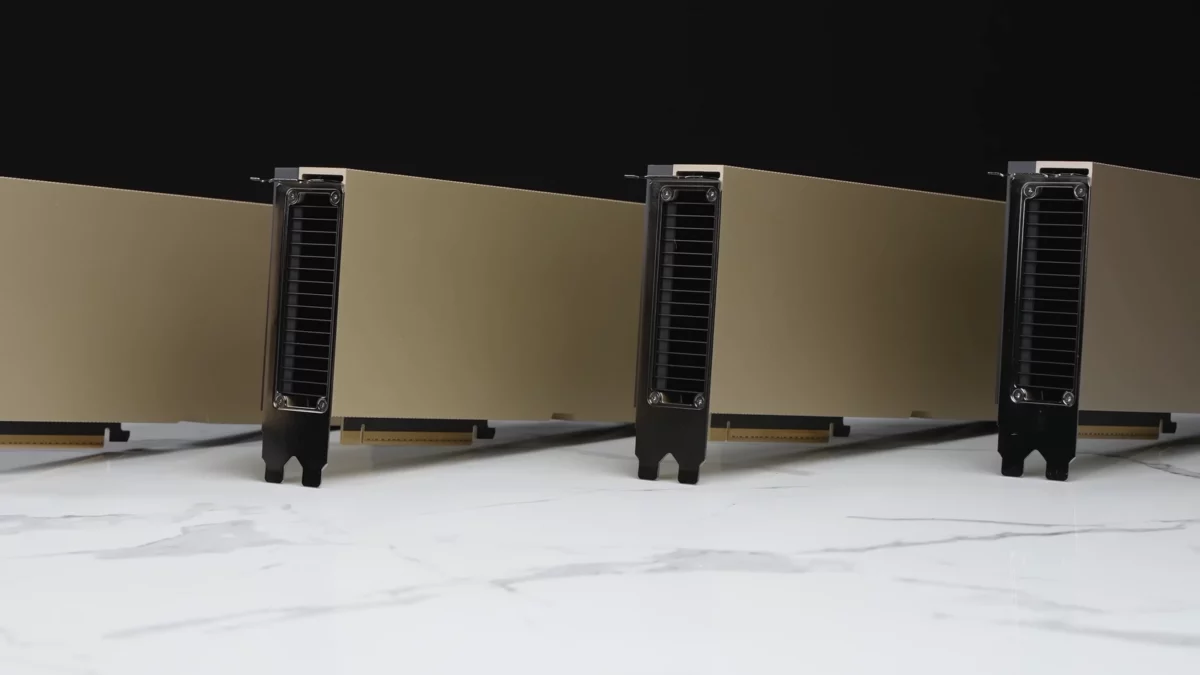 极客湾Geekerwan / Wikimedia Commons, CC BY 3.0
Wie viel Strom ein Sprachmodell für eine Antwort verbraucht
Ein Sprachmodell zerlegt Text in Tokens und sagt Stück für Stück das nächste voraus. Google kommt für eine typische Gemini-Anfrage auf 0,24 Wattstunden. Unabhängig geprüft ist der Wert nicht, und lange Anfragen kosten ein Vielfaches.
Über den Stromhunger von Chatbots kursieren zwei Erzählungen. Nach der einen kostet jede Frage an ChatGPT zehnmal so viel Strom wie eine Google-Suche. Nach der anderen ist der Verbrauch vernachlässigbar. Beide Lager zitieren Zahlen, die sich um mehr als eine Größenordnung unterscheiden.
Die Erklärung liegt in der Technik. Ein großes Sprachmodell verbraucht Strom in zwei Phasen: einmalig im Training, wenn es aus riesigen Textmengen lernt, und bei jeder einzelnen Anfrage. Wie viel eine Anfrage kostet, hängt an der Länge von Frage und Antwort, an der Modellgröße und an der Frage, was eine Messung überhaupt mitzählt.
Seit 2025 legen erste Hersteller eigene Messwerte vor, unabhängige Forscher rechnen nach. Für kurze Textanfragen liegen ihre Werte nah beieinander. Bei langen Dokumenten und KI-Agenten gehen die Schätzungen weit auseinander, und keiner der Herstellerwerte ist unabhängig geprüft.
Inhalt
Wie ein Sprachmodell aus Tokens eine Antwort baut
Ein Sprachmodell liest keine Wörter, sondern Tokens. Das sind kurze Textbausteine, oft Silben oder häufige Wortteile. Google gibt für seine Gemini-Modelle an, dass ein Token etwa vier Zeichen entspricht. 100 Tokens ergeben im Englischen ungefähr 60 bis 80 Wörter.
Jedes Token übersetzt das Sprachmodell in eine lange Zahlenreihe. Diese Zahlen durchlaufen dann viele Rechenschichten, in denen Milliarden gelernter Gewichte stecken, die sogenannten Parameter. Am Ende steht eine Wahrscheinlichkeit für jedes mögliche nächste Token. Das Sprachmodell wählt eines aus, hängt es an den Text an und beginnt die Rechnung von vorn.
Eine Antwort von 400 Wörtern entsteht so in rund 500 Durchläufen. Bei jedem Durchlauf rechnen die Chips einmal durch alle aktiven Parameter. Daraus folgt die wichtigste Faustregel für den Stromverbrauch: Je größer das Modell und je länger der Text, desto mehr Rechenoperationen fallen an. Das Sprachmodell setzt dabei statistisch fort, was es im Training an Mustern gelernt hat.
Was der Transformer von 2017 verändert hat
Fast alle heutigen Sprachmodelle bauen auf einer Architektur auf, die acht Forscher, die meisten von Google, im Juni 2017 vorstellten. Ihr Aufsatz „Attention Is All You Need“ von Ashish Vaswani und Kollegen beschreibt den Transformer. Er verzichtet vollständig auf die bis dahin üblichen rekurrenten Netze, die Text Wort für Wort nacheinander abarbeiten.
An ihre Stelle setzten die Autoren einen Mechanismus namens Attention, auf Deutsch Aufmerksamkeit. Er gewichtet für jedes Token, welche anderen Tokens im Text für seine Bedeutung wichtig sind. So erkennt das Modell, worauf sich ein „sie“ am Satzende bezieht. Weil der Transformer alle Tokens gleichzeitig verarbeitet, lässt sich das Training auf viele Grafikprozessoren verteilen.
Das Team trainierte sein bestes Übersetzungsmodell Englisch-Französisch in 3,5 Tagen auf acht Grafikprozessoren. Nach eigenen Angaben übertraf es damit frühere Spitzenmodelle zu einem Bruchteil der Kosten. Mit dieser Parallelisierung konnten Entwickler immer größere Modelle trainieren, und damit wuchs auch der Strombedarf der Rechenzentren.
Wie sich der Strom auf Training und Inferenz verteilt
Im Training liest ein Sprachmodell gewaltige Textmengen und passt seine Parameter so lange an, bis es das jeweils nächste Token gut vorhersagt. Danach folgt meist ein Feinschliff mit menschlichem Feedback. Diese Phase beansprucht große Chip-Cluster über Wochen, fällt aber nur einmal pro Modellversion an.
Für das Sprachmodell GPT-3 mit 175 Milliarden Parametern haben Forscher um David Patterson von Google und der University of California, Berkeley, den Aufwand 2021 berechnet. Nach ihrer Studie zu Emissionen großer neuronaler Netze verbrauchte das Training 1.287 Megawattstunden. Es verursachte 552 Tonnen CO2-Äquivalent.
Inferenz heißt die zweite Phase: das Anwenden des fertigen Sprachmodells auf jede einzelne Anfrage. Sie kostet pro Vorgang wenig, summiert sich aber über Milliarden Nutzungen. Dieselbe Studie zitiert eine Schätzung von Nvidia, nach der 80 bis 90 Prozent der Rechenlast im maschinellen Lernen auf Inferenz entfallen. Für die Gesamtbilanz zählt deshalb vor allem der Strom pro Anfrage.
Der französische Hersteller Mistral AI hat im Juli 2025 eine Lebenszyklusanalyse seines Sprachmodells Mistral Large 2 veröffentlicht. Erstellt haben sie die Beratung Carbone 4 und die französische Umweltagentur ADEME. Für Training und 18 Monate Nutzung bis Januar 2025 nennt Mistral 20.400 Tonnen CO2-Äquivalent und 281.000 Kubikmeter Wasser. Ein zehnmal größeres Sprachmodell verursacht laut der Analyse bei gleicher Tokenzahl etwa zehnmal so hohe Umweltwirkungen.
Wie viel Strom eine einzelne Anfrage kostet
Lange stützte sich die Debatte auf Schätzungen von außen. Eine Rechnung von Alex de Vries aus dem Jahr 2023 setzte drei Wattstunden pro ChatGPT-Anfrage an. Das Forschungsinstitut Epoch AI hielt den Wert im Februar 2025 für wahrscheinlich zu hoch. Es kam für eine typische Anfrage an GPT-4o auf etwa 0,3 Wattstunden, bei einer Antwort von rund 500 Tokens.
Im August 2025 legte Google erstmals Messwerte aus dem eigenen Betrieb vor. Die mittlere Textanfrage an die Gemini-Apps verbrauchte im Mai 2025 laut Google 0,24 Wattstunden. Das entspricht nach Konzernangaben weniger als neun Sekunden Fernsehen. Dazu kommen 0,03 Gramm CO2-Äquivalent und 0,26 Milliliter Wasser.
Google zählt dabei mehr mit als nur die rechnenden Chips. In den Wert gehen Prozessoren und Arbeitsspeicher der Server ein, Reservemaschinen im Leerlauf sowie Kühlung und Stromverteilung im Rechenzentrum. Wer nur die aktiven KI-Chips misst, kommt auf 0,10 Wattstunden. Die Autoren um Google-Chefwissenschaftler Jeff Dean nennen diese enge Rechnung bestenfalls optimistisch.
Zugleich meldete Google, der Strom pro mittlerer Anfrage sei zwischen Mai 2024 und Mai 2025 um den Faktor 33 gesunken. OpenAI-Chef Sam Altman nannte im Juni 2025 in einem Blogbeitrag 0,34 Wattstunden für eine durchschnittliche ChatGPT-Anfrage. Eine Methode legte er nicht offen.
| Angabe | Strom pro Anfrage | Quelle und Stand |
|---|---|---|
| Gemini-Apps, mittlere Textanfrage, mit Rechenzentrum | 0,24 Wh | Google, Messung Mai 2025, veröffentlicht August 2025 |
| Gemini-Apps, nur aktive KI-Chips | 0,10 Wh | Google, August 2025 |
| ChatGPT, durchschnittliche Anfrage | 0,34 Wh | Sam Altman, OpenAI, Juni 2025, ohne Methode |
| GPT-4o, 500 Tokens Antwort (Schätzung) | ca. 0,3 Wh | Epoch AI, Februar 2025 |
| GPT-4o, 10.000 Tokens Eingabe (Schätzung) | ca. 2,5 Wh | Epoch AI, Februar 2025 |
| GPT-4o, 100.000 Tokens Eingabe (Schätzung) | knapp 40 Wh | Epoch AI, Februar 2025 |
| ChatGPT, ältere Schätzung | 3 Wh | Alex de Vries, 2023, zitiert nach Epoch AI |
Warum die Zahlen pro Anfrage so weit auseinanderliegen
Ein Wert pro Anfrage beschreibt nur einen Mittelwert. Google gibt ausdrücklich an, dass die 0,24 Wattstunden nicht für alle Textanfragen gelten. Ein unabhängiger Prüfer hat die Zahlen nicht testiert. Bilder und Videos deckt die Messung nicht ab.
Am meisten Strom kosten lange Texte. Lädt ein Nutzer ein langes Dokument hoch, muss das Sprachmodell jedes Token davon verarbeiten, bevor es antwortet. Epoch AI schätzt für 10.000 Eingabetokens rund 2,5 Wattstunden, für 100.000 Tokens knapp 40 Wattstunden. Andere plausible Annahmen zu Modellgröße und Auslastung ergeben laut Epoch Werte zwischen 0,1 und vier Wattstunden pro typischer Anfrage.
Sprachmodelle, die vor der Antwort lange „nachdenken“, schreiben intern viele zusätzliche Tokens und verbrauchen entsprechend mehr. Noch stärker fallen KI-Agenten ins Gewicht, die selbstständig mehrere Schritte nacheinander ausführen. Die Internationale Energieagentur (IEA) erwartet, dass solche neuen Nutzungsformen das Wachstum des Stromverbrauchs tragen.
Bei den Emissionen ziehen Mistral und Google die Grenzen unterschiedlich. Mistral kommt für eine Antwort von 400 Tokens auf 1,14 Gramm CO2-Äquivalent und 45 Milliliter Wasser, Google für Gemini auf 0,03 Gramm. Mistral setzt den Strommix am Standort an. Google zieht laut seinem Fachaufsatz den eingekauften CO2-freien Strom ab und senkt seinen Emissionsfaktor für 2024 so von 345 auf 94 Gramm pro Kilowattstunde. Einen gemeinsamen Standard für solche Bilanzen gibt es nicht, Mistral will mit seiner Analyse dazu beitragen.
Chiphersteller und Modellentwickler drücken den Strom pro Antwort weiter, mit besseren Chips und kleineren Modellen für einfache Aufgaben. Mit DeepSeek hat ein chinesisches Labor gezeigt, wie viel Effizienz in Architektur und Training steckt. Ob sinkende Kosten pro Anfrage den Gesamtverbrauch bremsen oder durch mehr Nutzung aufgezehrt werden, lässt sich heute nicht beziffern.
Was Sprachmodelle für Stromnetze und Klimaziele bedeuten
Pro Anfrage ist der Strom klein, in Summe nicht. Rechenzentren verbrauchten 2024 weltweit rund 415 Terawattstunden, etwa 1,5 Prozent des globalen Stroms. Bis 2030 erwartet die IEA in ihrem Bericht „Energy and AI“ vom April 2025 rund 945 Terawattstunden. Das wäre etwas mehr, als ganz Japan heute verbraucht.
Am schnellsten wächst der Verbrauch der Server mit KI-Beschleunigern, im Basisszenario der IEA um rund 30 Prozent pro Jahr, der herkömmlicher Server um neun Prozent. Für Europa rechnet die Agentur bis 2030 mit mehr als 45 Terawattstunden zusätzlich. Für 2035 reicht die Spanne ihrer Szenarien von 700 bis 1.700 Terawattstunden weltweit.
2025 stieg der Stromverbrauch der Rechenzentren laut IEA um 17 Prozent, der weltweite Strombedarf um drei Prozent. Zugleich sinkt der Strom pro KI-Aufgabe nach Einschätzung der Agentur so schnell wie bei keiner Energietechnik zuvor.
Für die Klimabilanz zählt, woher der Strom kommt. Die IEA bezifferte im Bericht von 2025 die Emissionen aus dem Strom der Rechenzentren auf rund 180 Millionen Tonnen CO2 im Jahr. Weil neue Gasturbinen knapp sind, finanzieren Google und Meta Erdwärme und Langzeitspeicher (mehr dazu: Geothermie für KI-Rechenzentren).
Die Wärme der Server lässt sich in Fernwärmenetze einspeisen (mehr dazu: Rechenzentren und ihre Abwärme). Umgekehrt setzen Netzbetreiber KI für die Energiewende ein. Der Übertragungsnetzbetreiber Amprion hat für den Einsatz von KI im Stromnetz eine eigene Firma gegründet. Ob KI dem Klima am Ende mehr nützt als der Ölförderung, bleibt offen (mehr dazu: KI in der Energiewirtschaft).
QUELLEN
- Alex de Vries: Schätzung zum Strombedarf von ChatGPT, 2023, zitiert nach Epoch AI.
- Nvidia: Schätzung zum Inferenzanteil der Rechenlast im maschinellen Lernen, 2019, zitiert nach Patterson et al., 2021.
 I2ho7p / Wikimedia Commons, CC BY-SA 4.0
WISSEN
 Slaunger / Wikimedia Commons, CC BY-SA 3.0
WISSEN
 NASA
WISSEN
 JoachimKohler-HB / Wikimedia Commons, CC BY-SA 4.0
WISSEN
 Molgreen / Wikimedia Commons, CC BY-SA 4.0
WISSEN
WISSEN